问题描述
什么是 McByte++
McByte++ 对应于论文《面向体育视频分析的免训练长期多目标追踪》(Stanczyk、Yoon 与 Brémond,arXiv:2608.15688)。它是一套基于检测的追踪系统:检测器在每一帧中找出人员,追踪 器则负责判断第 t 帧中的哪个目标框与第 t−1 帧中的目标框属于同一个人,并在时间维度上保持身份稳定。
它的核心贡献是能够在无需训练任何模型的情况下完成追踪。它以 ByteTrack 为核心,组合现成组件并加入三种线索:
掩码线索:为每条轨迹传播分割掩码,用于消除仅凭目标框重叠无法解决的匹配歧义
条件式相机运动补偿(CMC):估计全局相机运动,并从预测框中扣除该运动,但仅在估计结果可信时启用
在线长期重识别:当人员离开画面后再次出现时,外观记忆会恢复其原有 ID
上游实现使用 H100,以 8–20 FPS 运行,并分别采用 YOLOX-X 进行检测、EdgeTAM 生成掩码、OSNet 执行重识别。
关于此移植版本的说明
算法逻辑已按原方法忠实移植,但其依赖的三个神经网络并未原样移植,因为它们无法同时容纳在该芯片中。这是在 K230 上运行的 McByte++ 方法,而不是对论文已发布准确率的复现。请勿期待它达到 SoccerNet 论文中的指标。
| 修改项 | 上游实现 | 本移植方案 |
|---|---|---|
| YOLOX-X 检测器 | YOLOv5n 人体检测 kmodel | 置信度标定不同,对小目标或被遮挡人员的检测较弱 |
| EdgeTAM 掩码传播 | 在预测框内进行亮度带分割 | 主体与背景亮度有差异时有效,否则不起作用 |
| OSNet 重识别嵌入 | 8×16 空间颜色布局描述符 | 可区分着装不同的人员,但无法区分相同队服 |
| lap.lapjv | 手写 Jonker–Volgenant 求解器 | 等效 |
其余部分——两阶段关联、卡尔曼滤波、轨迹生命周期、两种掩码比率及其阈值、CMC 可靠性策略,以及完整的重识别协议——均与论文一致。
硬件准备
- K230 开发板
- 摄像头
- 显示器
软件架构
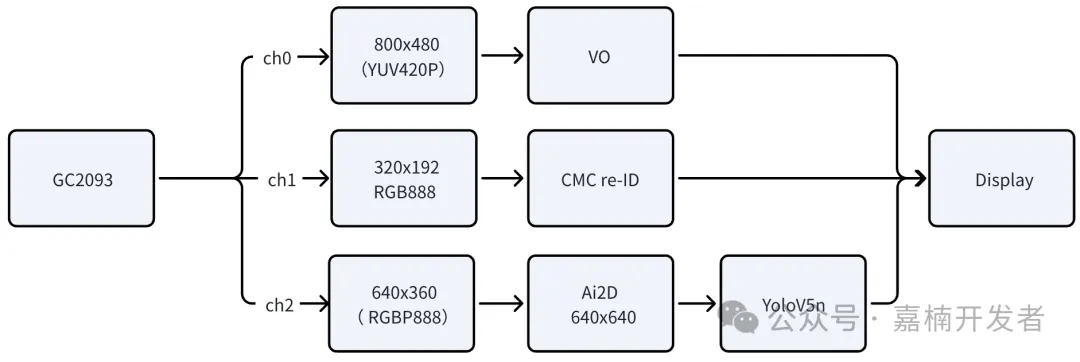
两个关键特性
-
chn0 完全不经过 Python:该通道通过硬件绑定至视频层,因此即使 Python 循环停滞或崩溃,实时画面仍会继续显示。这会造成真实的调试风险:程序已经冻结,看起来却仍然像在运行。
-
chn2 被有意设置为 640×360:模型输入为 640×640;Letterbox 以 1.0 比例处理 640×360,并填充至 640×640。若改用 1280×720,ai2d 进行 2 倍缩小后得到的模型输入在字节层面完全相同,却需要 4 倍帧缓冲区(2.76 MB 对比 691 KB)。因此使用较小通道几乎没有额外代价。
单帧处理流程
该流程位于 app.py 的 main() 中,并对应论文第 3.4 节。
步骤 1:采集
- snapshot() 在 chn2 上获取检测帧;to_numpy_ref() 将其以 CHW uint8 数组形式公开且无需复制
- chn1 则以普通的 image.Image 格式提供辅助帧
- 任一通道都可能失败:固件会返回整数 -1 而不是图像帧。系统会检查两者;一旦采集失败,就跳过当前帧
步骤 2:检测
- ai2d 将 640×360 以 Letterbox 方式处理为 640×640(上下各填充 140 行),然后送入 KPI
模型输出三张特征图,分别对应步长 8、16 和 32 - aicube.anchorbasedet_post_process 负责解码锚框并执行 NMS,返回 [label, score, x1, y1, x2, y2]
- 输出为列表,每项采用检测帧坐标,格式为 [x1, y1, x2, y2, score]
步骤 3:预测
- 每条轨迹通过恒速卡尔曼滤波器向前预测一步
- 状态为 8 维——(x, y, a, h, vx, vy, va, vh)——表示目标框中心、宽高比、高度及其对应速度
- 与 ByteTrack 相同,过程噪声和测量噪声均随目标高度缩放,因此远处的小目标会采用更严格的置信范围
- 对于丢失的轨迹,首先将高度速度清零:因为无法确认目标是否仍在移动,若允许其无限惯性漂移,目标框可能最终偏离屏幕上千像素
步骤 4:补偿相机运动(CMC)
- 当相机发生平移时,即使人员未移动,所有目标框也会产生位移
- CMC 会估计该全局位移,并在匹配之前将其应用于预测结果
- 估计来自辅助帧与上一帧的相位相关:先将辅助帧缩小为 128×128 灰度图,再与上一帧比较
仅在以下条件满足时接受估计: - 相关响应高于 cmc_min_response(0.25)
- 两个轴向上的估计位移均小于画面尺寸的 25%
- 被拒绝的估计不会覆盖已保留结果;最近一次有效估计会继续复用 cmc_hold_frames 帧,随后才被放弃
- 系统补偿水平和垂直平移,但不补偿旋转与缩放(除非启用 cmc_similarity,默认关闭)
步骤 5:构建代价矩阵
- cost[i][j] = 1 − IoU(track_i, detection_j)。仅此而已;按照设计,外观信息不会参与逐帧匹配。
步骤 6:应用掩码线索
每条轨迹都携带一个掩码。针对每个候选框,会计算两个像素计数比率:
- mc = |mask_i ∩ bbox_j| / |mask_i|(覆盖率——门控项)
- mf = |mask_i ∩ bbox_j| / |bbox_j|(填充率——判别项)
- 当该配对处于歧义状态或孤立状态时,会降低代价:cost[i][j] = cost[i][j] − mf if mf ≥ 0.05 and mc ≥ 0.90
本方案如何生成掩码:EdgeTAM 属于 Transformer 模型,无法与检测器同时装入芯片。因此,每条轨迹改为维护一个亮度带——取匹配框中心 60% 区域的均值 ± 2.5·MAD,并以 EMA 更新。掩码由其预测框内亮度落入该范围的网格单元组成,并在 80×48 的均值池化网格上计算。系统使用积分图为每条轨迹、每一帧构建数据,使交集查询可在 O(1) 时间内完成。
步骤 7:分配(匈牙利算法)
- 使用 Jonker–Volgenant 最短增广路径实现匈牙利分配
- 数据结构为普通 Python 列表(轨迹数量通常只有几十条,O(n³) 可忽略)
- 超过阈值的配对会被赋予极大代价而排除在求解器之外
步骤 8:BYTE 第二阶段匹配与生命周期
检测结果按置信度分为:
高置信度(≥ track_thresh):与所有轨迹匹配,代价 ≤ 0.8
低置信度(≥ conf_low):再与尚未匹配的轨迹进行匹配,并采用更严格的代价 ≤ 0.5
核心观点:处于正确位置的弱检测通常代表一个被部分遮挡的真实人员——这比直接丢弃检测并宣布轨迹丢失更有价值。未匹配轨迹会进入丢失状态,并仅凭预测继续保留 track_buffer(30)帧,随后才会被移除。
步骤 9:长期重识别
重识别被有意设计为不参与逐帧匹配,只会在以下两个位置触发:
每次可靠匹配时,提取描述符并执行 ℓ2 归一化,再合并到轨迹的动态平均值中
轨迹终止时,将该平均描述符与轨迹 ID 一并存入长期身份记忆
新轨迹创建时,查询身份记忆。匹配必须满足双向最佳一致——新轨迹的最佳候选也必须将该新轨迹列为自身的最佳候选,且余弦相似度 ≥ 0.8。
本方案中的描述符:将裁剪图像重采样为 8×16 缩略图,读取为 384 维向量,然后在归一化前进行均值中心化。该描述符依赖服装颜色及其垂直分布。它能较好地重识别穿着不同颜色服装的人员,但对穿相同队服的队友效果较差。
步骤 10:绘制
叠加内容绘制到 ARGB8888 OSD 图像并推送至 OSD 层,由 VO 与实时视频混合
每条轨迹包括彩色目标框(若身份为恢复所得则加粗)、ID 标签和渐隐的地面接触轨迹
状态栏显示 FPS、轨迹数量、重识别命中次数和 CMC 启用状态
所有尺寸均根据面板高度计算,因此同一套代码在 800×480 LCD 和 1080p 显示器上都清晰可读
坐标空间
系统同时存在四种坐标空间。混淆它们极易引入隐蔽缺陷:
| 空间 | 尺寸 | 用途 |
|---|---|---|
| 检测帧 | 640×360 | 全部追踪处理:检测、卡尔曼状态、IoU、MOT 输出 |
| 辅助帧 | 320×192 | CMC 输入、重识别裁剪 |
| 掩码网格 | 80×48 | 仅用于掩码线索(辅助帧 ÷ mask_grid_div) |
| 显示面板 | 800×480 | 仅用于绘制 |
检测帧是标准坐标空间。轨迹中不会存储其他坐标空间的数据。坐标转换只发生在边界处。
LCD 比例为 5:3,而传感器为 16:9,因此画面会在水平方向压缩约 6%,而不是被裁剪。
代码说明:
代码路径位于SDK目录,最新的Daily Build会自动打包demo:
~/src/canmv/resources/examples/30-McByte++
| 文件 | 职责 |
|---|---|
| main.py | 程序入口 + 启动保护 |
| mcbytepp/config.py | 全部可调参数,标记为 [paper] 或 [k230] |
| mcbytepp/app.py | 传感器流水线、Renderer、MOT 输出、主循环 |
| mcbytepp/detector.py | ai2d + KPI + aicube 后处理 |
| mcbytepp/tracker.py | McByte++ 流水线(步骤 2–8) |
| mcbytepp/strack.py | 单条轨迹:状态、生命周期、特征平均值 |
| mcbytepp/kalman.py | 基于 ulab 的 ByteTrack 恒速滤波器 |
| mcbytepp/lap.py | Jonker–Volgenant 分配 + IoU 代价 |
| mcbytepp/maskcue.py | 掩码引导信号(论文 §3.1) |
| mcbytepp/cmc.py | 条件式运动补偿(论文 §3.2) |
| mcbytepp/reid.py | 长期重识别(论文 §3.3) |
| mcbytepp/selftest.py | 合成端到端检查,无需摄像头或模型 |
| mcbytepp/diag.py | 分阶段启动,用于隔离固件级故障 |
关键参数
| 设置项 | 数值 | 来源 |
|---|---|---|
| conf_low | 0.10 | 检测器最低阈值 |
| track_thresh | 0.35 | 论文为 0.6——已重新标定 |
| new_track_thresh | 0.45 | 论文 / ByteTrack 为 0.7——已重新标定 |
| match_thresh | 0.8 / 0.5 / 0.7 | ByteTrack(第一阶段 / 第二阶段 / 未确认) |
| track_buffer | 30 帧 | ByteTrack |
| mask_mc_min / mask_mf_min | 0.90 / 0.05 | 论文数值,未修改 |
| reid_sim_thresh | 0.8 | 论文数值,未修改 |
| cmc_size | 128 | 必须保持正方形且边长为 2 的幂 |
开发板实测结果
| 项目 | 实测值 |
|---|---|
| 传感器 | GC2093 CSI-2,原生 1920×1080@30 |
| 显示面板 | ST7701,800×480 |
| chn2 快照(640×360 RGBP888) | 约 36 ms,连续 5 次无丢帧 |
| kmodel 加载 | 361 ms |
| KPI 张量 | 1 个输入,3 个输出 |
| 空闲状态下可用的 MicroPython 堆内存 | ~4.1 MB |
| 完整循环,3 通道 @1280×720 | 15.7 FPS |
| 帧缓冲区开销,chn2 @640×360 | 691 KB(1280×720 时为 2.76 MB) |
本次移植对原算法网络做了适配修改,仅供开发者学习研究使用。 Demo 代码已内置在 CanMV SDK 示例中,大家可以下载 SDK,在 K230/K230D 开发板上亲手体验这套免训练多目标追踪方案。
视频演示:
https://www.bilibili.com/video/BV1YrWw6xEG9/
欢迎动手调参测试,把你的开发成果分享到社区,一起探索边缘 AI 多目标追踪更多可能性!
